视频不是数据:为什么「看会了」不等于「会做」
视频能给运动先验、场景多样性、长尾事件,但给不了动作、奖励、力觉、旋转真值和闭环。它是世界模型的预训练燃料,不是强化学习的环境。
二、视频缺什么:五样东西
三、三条补救路线:翻译、模拟、真机
四、数据量级的幻觉:100 万小时 vs 62 小时
五、2026 年的新证据:视频派的进步与边界
六、球类视频的五个坑
七、正确的三段式:视频 → 仿真 → 真机
八、投资映射:谁在卖"数据",谁在卖"数据的故事"
九、反方观点:三种"视频派"的说法
十、结语:教材与教练
数据与来源
先做一个思想实验。
假设你把 YouTube 上所有能找得到的网球视频,全部喂给一个模型:四大满贯、ATP 巡回赛、奥运会、教学视频、业余比赛,加起来几十万小时,4K 画质,多机位。
然后你问它:现在给你一个以 180 公里/小时飞来的发球,你知道该怎么接吗?
它大概会告诉你:球会往这边飞,落点大概在这里,弹起来之后会往那边走。
这些都对。但它接不回来。
因为它看得懂球,但没有打过球。
这就是今天所有"视频派"世界模型面临的处境:视频能让模型"看懂",但不能让它"会做"。而这两件事之间,隔着的不是数据量,是动作、奖励、力觉、旋转和闭环。
一、视频给了什么:三份礼物
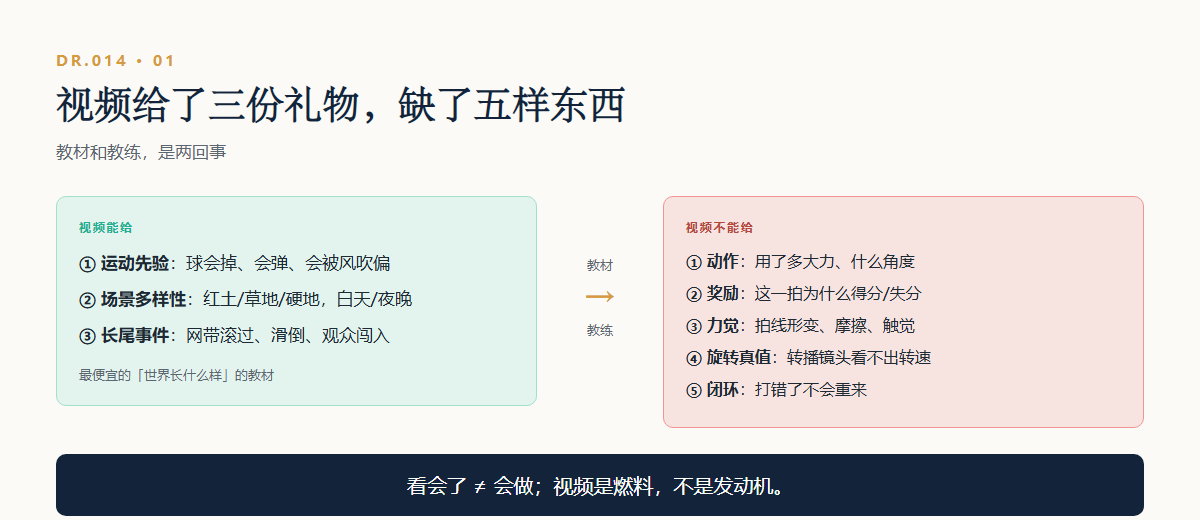
先说公平话。视频不是没用,它给了三样非常宝贵的东西。
第一份礼物:运动先验。
球会往下掉,会弹起来,会被风吹偏;人挥拍的时候,重心会先动,手臂会滞后,击球点会在身体侧前方。这些东西,文字写不出来,规则也写不全,但视频里全是。模型看多了,就"知道"了。
Genie 3 就是最好的例子:网络里没有写重力,但看过足够多"球往下掉"的视频之后,它学到的分布就是"球通常会往下掉"。这叫涌现的物理。
第二份礼物:场景多样性。
红土、草地、硬地,室内、室外,白天、夜晚,不同的球速、不同的灯光、不同的观众背景。真实世界采集这些数据极其昂贵,但视频里天然就有。
第三份礼物:长尾事件。
球打在网带上滚过去、球员滑倒、观众突然闯入、风向突变。这些事在训练场里一辈子遇不到几次,但在视频里,你能找到成千上万个样本。
所以视频的价值是真实的:它是最便宜的"世界长什么样"的教材。
但教材和教练,是两回事。
二、视频缺什么:五样东西
视频缺的第一样,是动作。
视频里只有"结果",没有"动作"。你看到球员把球打回去了,但你不知道他用了多少力、手腕是什么角度、击球点在哪里、身体重心怎么转移。
有人会说:那就用逆动力学模型,从相邻两帧反推动作。
这叫 latent action(隐含动作)。它确实能推断出"大概往哪个方向动了",但推不出"用了多大力",也推不出"机器人的关节该怎么动"——因为视频里的人是人的身体,不是机器人的身体。
没有动作,就算不出策略梯度。 这是强化学习和监督学习最根本的区别:监督学习只需要"输入-输出",强化学习需要"状态-动作-结果"。
视频缺的第二样,是奖励。
你看到球出界了,但你不知道是"判断错了"还是"执行错了";你看到这一分赢了,但不知道是"这拍打得好"还是"对手失误"。视频里有比分,但没有每一拍的因果。
而没有奖励,模型就不知道往哪个方向优化。它只能学"人是怎么打的",不能学"怎么打才能赢"。
视频缺的第三样,是力觉。
拍线会形变,球拍会震动,鞋底会打滑,手指会调整握拍力度。这些东西,摄像头拍不到。
而球类恰恰是"接触丰富"的任务:击球那一瞬间的力,决定了球的旋转和落点。没有力觉,模型只能"看着像",不能"打得准"。
视频缺的第四样,是旋转真值。
这是球类最要命的一条。
乒乓球的旋转可以超过每秒 1000 弧度;网球的上旋可以到每分钟几千转。旋转会改变飞行轨迹(马格努斯效应)和弹跳方向,是职业选手的核心武器。
但转播镜头看不出转速。你只能看到球在飞,看不到球在转。
索尼 Ace 为了测旋转,用了 9 个高速相机 + 3 套事件相机 + 可调焦镜头,才把角速度估出来。这不是"算法问题",是"传感器问题"——视频里根本没有这个信息。
视频缺的第五样,是闭环。
视频是录好的。你打错了,它不会重来;你想试试"如果这一拍打直线会怎样",它不会给你反馈。
而强化学习的本质,就是试错。没有交互,就没有试错;没有试错,就没有探索;没有探索,策略就只能模仿,不能超越。
一句话总结:视频是"别人打给你看",强化学习是"你自己打给自己看"。前者能让你看懂,后者才能让你打赢。
三、三条补救路线:翻译、模拟、真机
那怎么办?行业里有三条路。
第一条,把视频"翻译"成动作数据。
代表方法是 latent action:训练一个逆动力学模型,输入相邻两帧,输出"中间发生了什么动作";再用这个"伪动作"去做行为克隆。
LAPA、UniVLA 这类工作做的就是这件事。好处是能把海量视频利用起来;坏处是"翻译"出来的动作没有力、没有本体约束、没有奖励,只能做预训练,不能直接部署。
它是翻译,不是采集。
第二条,用仿真。
Isaac Lab、MuJoCo 这些物理仿真器,可以让你在虚拟世界里无限次试错:球速、旋转、摩擦、风力,全都可以调;失败了,一键重置;想测一百万次,就测一百万次。
这是目前最主流的路线。DeepMind 的乒乓球机器人,低级技能库就是在 MuJoCo 里训出来的;索尼 Ace 也是在大规模仿真对战中积累经验,再迁移到真实世界。
但仿真有一个绕不过去的问题:sim-to-real gap(仿真到现实的差距)。 接触、摩擦、柔性、旋转,这些在仿真里最难标定,而它们恰恰是球类的核心。行业公开的估计是,sim-to-real 的性能损失在 50% 到 80% 之间。
仿真器到底在算什么、给 AI 什么?
MuJoCo 和 Isaac Lab 代表两条实现路径:
- MuJoCo:用广义坐标描述机器人,先算关节加速度,再积分出下一步状态;接触用凸优化/软约束求解,擅长 articulated body 的动力学。MJX 把同一套模型搬到 GPU/TPU 上并行。
- Isaac Lab:长在 Isaac Sim / Omniverse 上,底层是 PhysX 5,用 USD 组织场景;一张 GPU 上并行几千个环境,每个环境独立 reset、随机化。
| MuJoCo | Isaac Lab | |
|---|---|---|
| 物理引擎 | 广义坐标 + 凸接触/软约束 | PhysX 5 / USD |
| 并行方式 | MJX(GPU/TPU) | 单 GPU 数千环境 |
| 强项 | 关节机器人、接触精细、轻量 | 大规模 RL、照片级渲染、传感器 |
| 给 AI 的数据 | qpos/qvel、力矩、接触力、传感器 | 本体状态、RGB/深度/LiDAR、接触、物体位姿、reward/termination |
| 典型用户 | DeepMind、OpenAI、学术 | NVIDIA、机器人公司、RL 实验室 |
两者给 AI 的不是「一段视频」,而是交互轨迹:每一步的观测(关节位置/速度、末端位姿、物体位姿、接触力、RGB/深度/LiDAR)、动作、奖励、是否终止。RL 的循环是 reset → action → step → obs/reward/done,数据是模型自己「走」出来的,不是预先拍好的。
第三条,用真机。
遥操作采集、人机对打、真实回合数据——这是最贵的一条路,也是最终决定成败的一条路。
贵到什么程度?遥操作的人力成本大约每小时 50 到 150 美元;一个专业遥操员 8 小时的班,只能产出 2 到 3 小时的有效数据。智元建了数采工厂,2026 年产能约 200 万小时/年;AgiBot World 开源了 100 万条轨迹、217 个任务、850TB 数据。
真机数据是"带动作、带力、带结果"的数据,这是视频永远给不了的。
三条路的关系,不是替代,是分工:
- 视频负责"预训练",让模型知道世界长什么样;
- 仿真负责"大规模试错",让策略学会怎么打;
- 真机负责"校正",让策略适应真实世界的摩擦、旋转和延迟。
Sony Ace 是这条分工的一个干净样本。 它没有用视频预训练,也没有学一个世界模型来做规划;它在 3000 小时以上的物理仿真里做 model-free RL,再在真机上用人类对手和自对弈微调。感知端靠 9 台高速相机 + 3 套事件相机,200Hz、10.2ms 延迟、450 rad/s 旋转;策略输出还要经过带硬约束的凸优化,才变成关节动作。它说明:在规则清楚、仿真可信、传感器够好的窄域里,「仿真 + 真机」可以跑通,视频不是必需品。 反过来,它也说明这套方法很难直接搬到开放环境——仿真器和传感器都要重做。
我给一个粗略的预算比例:1 : 10 : 100。视频最便宜但最粗,仿真中等但可控,真机最贵但决定成败。
很多团队死在"视频做完了,没钱做真机"。
四、数据量级的幻觉:100 万小时 vs 62 小时
过去一年,行业里最容易被误读的一组数字,是 V-JEPA 2 的。
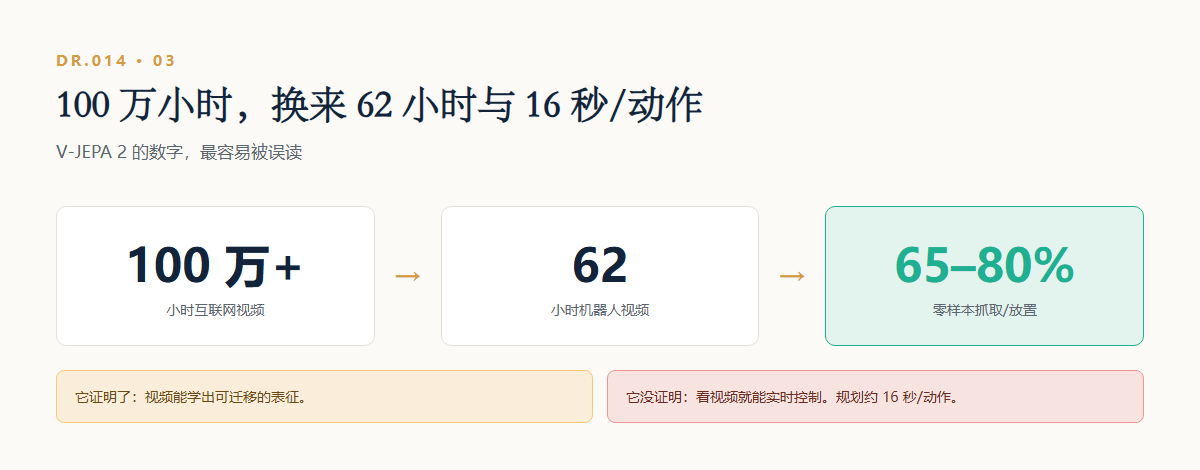
Meta 的 V-JEPA 2,用了 100 万小时以上的互联网视频做预训练,然后只补了 62 小时无标注机器人视频做动作条件化,就能在新环境里做零样本抓取和放置,成功率 65% 到 80%。
很多人看到"100 万小时",就得出"视频就够了"的结论。
但请注意两个细节。
第一,65% 到 80% 是"抓取和放置"的成功率,不是"打球"的成功率。 抓取是一个几秒钟的任务,状态空间小、动作空间小;打球是一个毫秒级、强对抗、部分可观测的任务。两者难度不在一个量级。
第二,它的规划速度是 16 秒/动作。 这意味着它能"想",但不能"控"。真正的球类控制,需要毫秒级闭环。
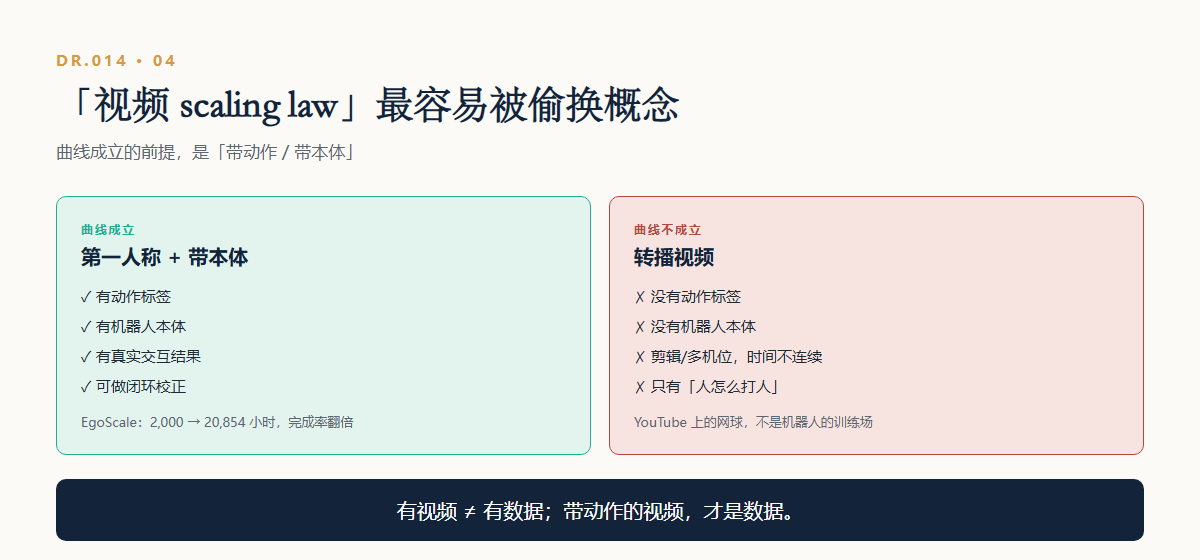
再看另一组数字。英伟达 EgoScale 用的是 20,854 小时人类第一视角视频(head-mounted,不是机器人视频),先预训练一个 VLA,再用 54 小时人机对齐的 play data 做中训练;从 1,000 小时到 20,854 小时,平均任务完成率翻倍以上,22 自由度灵巧手的平均成功率比无预训练基线高 54%。Dyna-2(Dyna Robotics)更进一步,用 100 万小时人类第一视角视频,预训练阶段零机器人数据,在 39 个跨本体任务上验证 scaling law;公司报告称客户现场通过率 87%,上一代 Dyna-1 是 46%,但这份结果未经独立复现。
但这些数据有一个共同前提:第一人称、带动作(或可重定向的动作),再加少量人机对齐数据。不是 YouTube 上的转播视频。
EgoScale 和 Dyna-2 甚至不需要机器人本体出现在预训练视频里——它们用的是人类第一视角,靠手部动作重定向到机器人;「带本体」的是中训练/后训练阶段的那一小段机器人数据。回到「第一人称带机器人本体是不是遥操」:遥操是最常见的采集方式(机器人头/腕相机 + 关节状态/动作),但机器人自主执行时录的也算;EgoScale/Dyna-2 则是人类第一视角 + 动作重定向,连机器人都没出现。
这就是「视频 scaling law」最容易被偷换概念的地方:曲线成立的前提是「第一人称 + 动作/可重定向 + 少量人机对齐」,不是「有视频就行」。「带机器人本体」不是必要条件;对球类这种本体差异大的任务,它才变得关键。
再往大了看:行业测算,训练一个人类水平机器人的「大脑」,大约需要 10 亿小时的物理交互数据;而截至 2026 年初,全球可用的高质量物理交互数据大约 50 万小时。缺口超过 99%。有研究者测算,按当前采集速度,达到 LLM 的智能程度需要约 12 万年。
这三组数字是怎么来的,得拆开看:
- 10 亿小时:行业对「通用具身模型」的量级估算,不是论文结论;不同机构口径从 1B 到 10B 小时不等。
- 50 万小时:截至 2026 年初全球高质量真机 + 无本体有效数据的存量;口径从 50 万到 500 万小时都有。
- 12 万年:把 LLM 训练数据折算成约 12 亿小时,再除以 π0 每年约 1 万小时的采集速度,得到 12 万年。它是「按现速外推」的思想实验,不是预言。
这就是为什么"视频"看起来像救命稻草——它是唯一一个"近乎无限、被动产生、免费"的数据源。
但它不是"物理交互数据",它是"物理观察数据"。
观察和交互,差一个动作。
五、2026 年的新证据:视频派的进步与边界
过去一年,视频派确实进步了。三个新结果,值得放在一起看。
第一,V-JEPA 2.1:表征更密了。
2026 年 3 月,Meta 发布 V-JEPA 2.1:ViT-G、20 亿参数,dense predictive loss + deep self-supervision;Ego4D 短时物体交互预测 7.71 mAP,EPIC-KITCHENS 高层动作预测 40.8 Recall@5,真实机器人抓取成功率比 V-JEPA 2-AC 提升 20 个百分点。
这说明"从视频学表征"这条路是通的。但它的用法仍然是"冻结编码器 + 规划",不是"实时闭环控制"。
第二,Dreamer 4:视频 + 少量动作标签,可以在想象里学会长程任务。
2025 年 9 月,Dreamer 4 用 2,541 小时 Minecraft 视频(其中约 100 小时带动作标签)+ transformer 世界模型 + shortcut forcing,首次在纯离线数据上挖到钻石(成功率 0.7%),单卡 H100 约 20 FPS,数据量比 OpenAI VPT 少约 100 倍。
这是目前"视频作为燃料"的最强证据。但它的域是 Minecraft:状态干净、动作离散、奖励明确、可离线反复采样。物理世界没有这些。
第三,Genie 3 / Street View:视频数据的"地主"出现了。
Project Genie 接入约 2800 亿张 Street View 图像、覆盖 110 个国家,可以生成真实地点的可探索世界。但 DeepMind 自己说,它只有"video game quality",不尊重物理,会话限制 60 秒,比视频生成落后 6–12 个月。
更重要的是:这是 Google 的数据,不是公开数据。创业公司拿不到 2800 亿张街景,也拿不到 YouTube 的全量视频授权。视频数据的竞争,正在从"谁有模型"变成"谁有地主"。
| 结果 | 时间 | 做了什么 | 证明了什么 | 没证明什么 |
|---|---|---|---|---|
| V-JEPA 2.1 | 2026-03 | 更密的视频表征,抓取 +20 个百分点 | 视频能学出可迁移的表征 | 仍是规划器,不是毫秒级控制器 |
| Dreamer 4 | 2025-09 | 2,541 小时视频 + 少量动作标签,离线挖钻石 | 视频 + 少量动作可以支撑"想象训练" | 游戏域可离线,物理域不行 |
| Genie 3 / Street View | 2026-05 | 2800 亿张街景,生成真实地点 | 视频世界模型可以规模化、地理落地 | 不尊重物理,60 秒会话,数据不公开 |
这三个结果合起来,说明什么?
视频能提供越来越好的表征和先验,甚至能支撑"在想象里训练";但它仍然需要三样东西才能变成控制:
- 动作标签(哪怕少量);
- 一个可交互、可重置、可测量的世界模型;
- 真机闭环校正。
Dreamer 4 把第 1、2 样在游戏里做到了;V-JEPA 2.1 把表征做到了;但球类需要的是第 3 样——毫秒级、接触丰富、对抗性的真机闭环。这就是为什么球类仍然难。
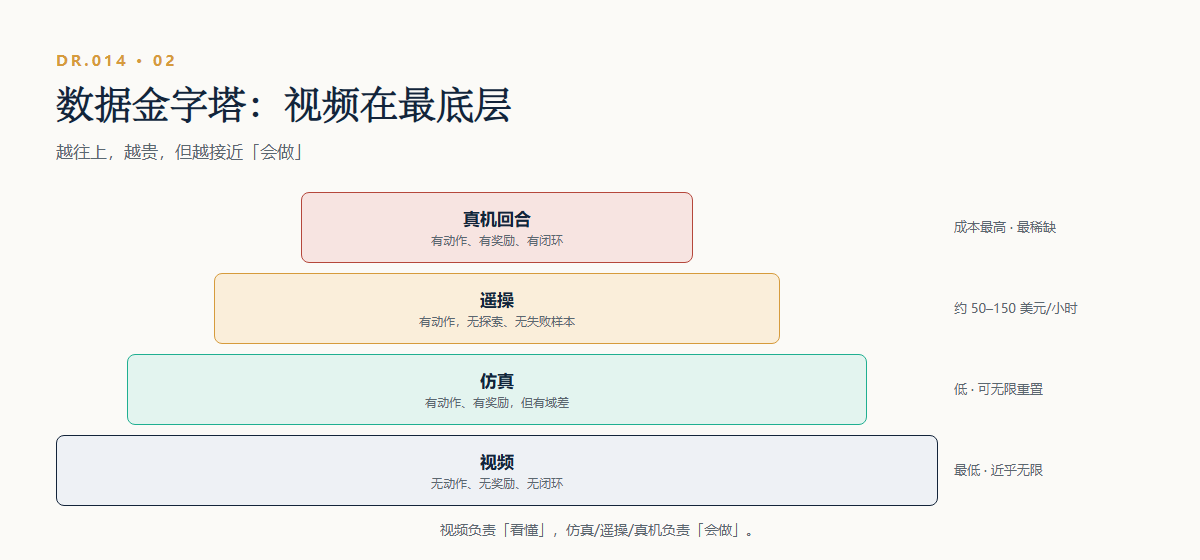
把四种数据放在一起,层级会更清楚:
| 层级 | 数据 | 成本/小时 | 信号质量 | 能训什么 |
|---|---|---|---|---|
| 视频 | 转播、第一人称、街景 | 最低 | 无动作、无奖励、无闭环 | 表征、先验、世界模型预训练 |
| 仿真 | 物理引擎生成 | 低 | 有动作、有奖励,但有域差 | 策略预训练、域随机化 |
| 遥操 | 人示范 | 约 50–150 美元 | 有动作,无探索、无失败样本 | 模仿学习打底 |
| 真机回合 | 机器人与人/环境交互 | 最高 | 有动作、有奖励、有闭环 | 最终校正、对抗与恢复 |
智元合伙人姚卯青给过一个更刺眼的对比:具身数据无论按 token 还是按小时算,与头部大语言模型的训练数据相比,可能差 1 万倍以上;行业要达到 1 亿小时级别,才可能让常见任务的基础成功率达到 70%–80%。他还提醒,互联网视频的分布和机器人需要的物理数据有本质差异——很多内容是娱乐性的,甚至反物理规律。
这句话很重要:视频不是"更便宜的真机数据",它是"另一种东西"。 它在金字塔底,负责让模型"看懂";仿真、遥操、真机在塔尖,负责让模型"会做"。
六、球类视频的五个坑
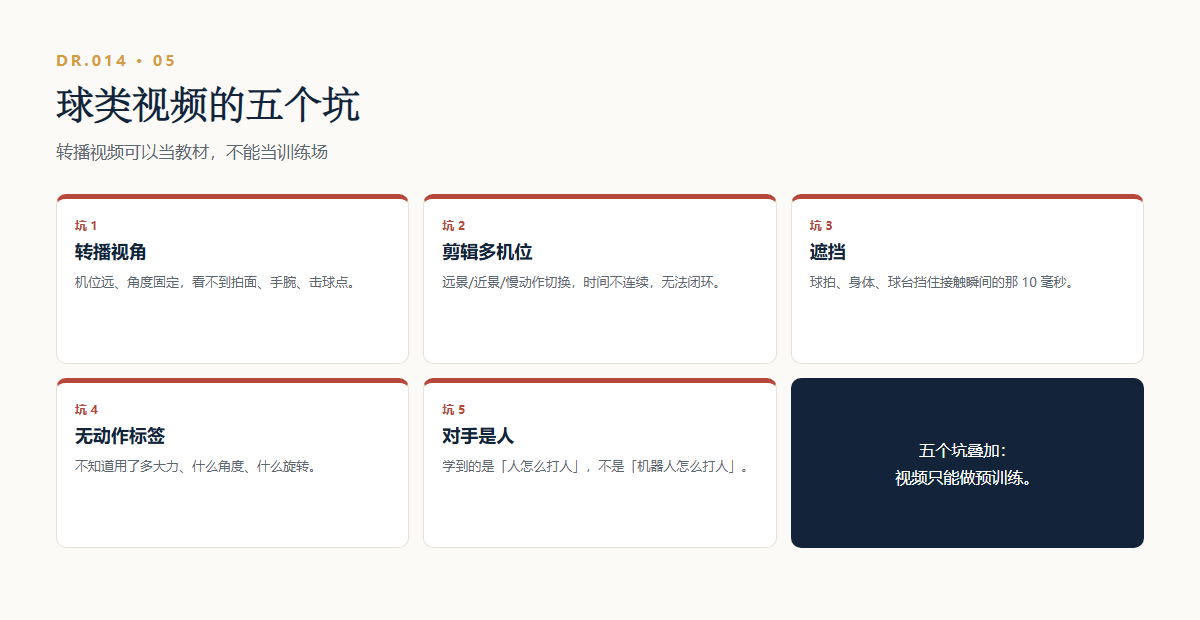
如果你真的想用视频训球类机器人,还有五个坑在等你。
坑一:转播视角。
职业比赛的机位在观众席后方,距离远、角度固定,看不到拍面角度、手腕动作、击球点。而这些恰恰是"怎么打"的关键。
坑二:剪辑和多机位。
转播是切镜头的:远景、近景、慢动作、观众反应。时间不连续,无法做闭环训练。你拿到的不是一条连续轨迹,而是一堆"精彩瞬间"。
坑三:遮挡。
球拍、身体、球台、网带,都会在关键瞬间挡住球。而接触的那 10 毫秒,正是最需要数据的地方。
坑四:没有动作标签。
视频里没有"这一拍用了多少力、什么角度、什么旋转"。你可以用逆动力学去猜,但猜出来的动作,和机器人本体的动作空间对不上。
坑五:对手是人。
视频里的对手是人,动作分布是人的;而你的机器人,关节数量、力矩、运动学都不同。你学到的是"人怎么打人",不是"机器人怎么打人"。
五个坑叠加起来,结论很清楚:转播视频可以当教材,不能当训练场。
七、正确的三段式:视频 → 仿真 → 真机
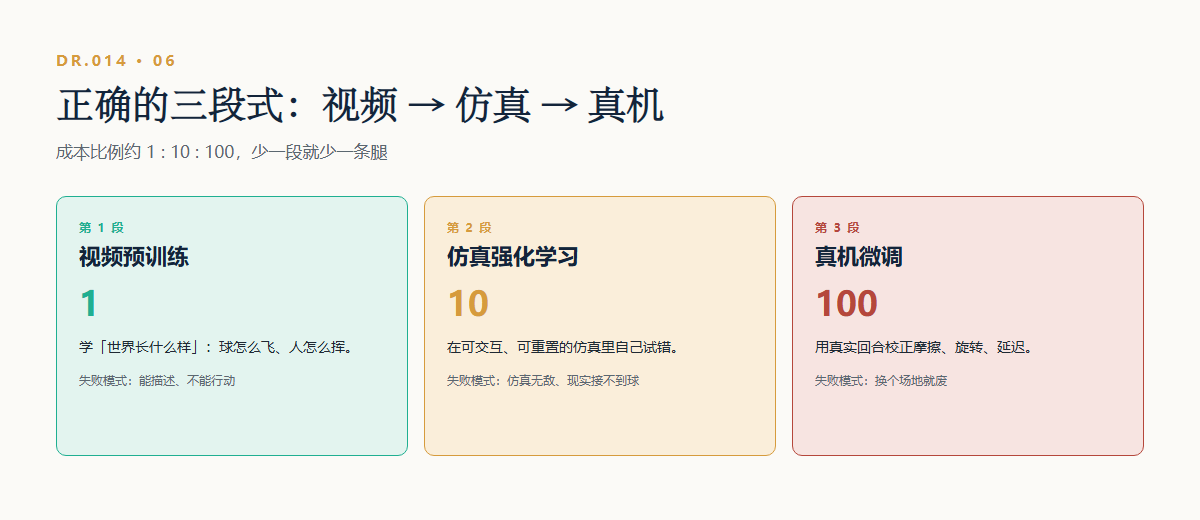
那正确的做法是什么?
三段式。
第一段,视频预训练。
用海量视频学"世界长什么样":球怎么飞、人怎么挥、场地怎么变。这一步的目标不是"会打",是"有常识"。成本最低,可以大规模做。
第二段,仿真强化学习。
在可交互、可重置、可测量的仿真里,让策略自己试错:发球、接球、落点、旋转。这一步的目标是"会打",但只是"在仿真里会打"。
关键是 domain randomization(域随机化):把球速、旋转、摩擦、光照、延迟都随机化,让策略见过足够多的"变体",这样迁移到现实时才不会崩。
第三段,真机微调。
用真实回合数据校正 sim-to-real 的差距:真实的旋转、真实的摩擦、真实的延迟、真实的对手。这一步最贵,但决定了"能不能上场"。
三段的失败模式也不同:
- 视频预训练失败,模型会"能描述、不能行动";
- 仿真 RL 失败,模型会"仿真无敌、现实接不到球";
- 真机微调失败,模型会"在训练场能打、换个场地就废"。
三段都做,才有机会。少一段,就少一条腿。
八、投资映射:谁在卖"数据",谁在卖"数据的故事"
| 环节 | 谁在卖 | 判断 |
|---|---|---|
| 视频数据 | 视频平台、数据集公司 | 便宜,但缺动作,价值被高估 |
| 第一人称/带本体视频 | 数据采集公司、遥操工厂 | 真数据,可定价 |
| 仿真 | Isaac、MuJoCo 生态、云仿真 | 卖水人,稳定 |
| 真机回合数据 | 数采工厂、场馆运营方 | 最贵,最稀缺 |
| 数据标注/清洗 | 标注公司、数据服务 | 低毛利,靠规模 |
一句话:视频是"免费的教材",仿真和真机是"收费的教练"。教材能自学,但考试得靠教练。
如果你看一家公司的 BP,它说"我们有 100 万小时视频数据",你要问三个问题:
- 这些视频是第几人称?有没有本体?有没有动作标签?
- 你们用这些视频做了什么?预训练、行为克隆,还是直接当 RL 环境?
- 从视频到真机,中间补了多少小时仿真、多少小时真机?
三个问题答完,你就知道它是在"卖数据",还是在"卖数据的故事"。
九、反方观点:三种"视频派"的说法
说法一:视频 scaling law 已经出现了,为什么还说视频不够?
回应:scaling law 成立,但前提是"第一人称 + 带动作 + 带本体"。EgoScale 的 2,000 到 20,854 小时,是机器人第一人称视频;DYNA-2 的 100 万小时,也是"人-机"数据。转播视频不具备这个前提。
说法二:LeCun 说了,表征预测就够了,不需要动作标签。
回应:V-JEPA 2 确实证明了"不生成像素也能规划",但它的规划速度是 16 秒/动作。它能"想",不能"控"。要控制,还是要有动作条件、有闭环。
说法三:世界模型可以替代仿真器。
回应:可交互不等于可标定。生成模型可以补长尾、补真实感,但它的物理参数不可信,做不了 domain randomization。正确姿势是"仿真打底 + 生成补长尾"。
十、结语:教材与教练
回到开头那个思想实验。
把 YouTube 上所有网球视频喂给模型,它能学会什么?
它能学会:球大概会往哪飞、落点大概在哪、人大概会怎么挥拍。
它学不会:这一拍该用多少力、该打什么旋转、该怎么调整步伐、打错了怎么补救。
视频能教会模型"球是怎么飞的",但教不会它"怎么把球打回去"。
因为"打回去"这件事,需要动作、需要奖励、需要在真实世界里试错、需要被对手打回来再打回去。
这就是为什么,球类机器人这波进步,真正的主角不是"视频",是事件相机、物理仿真、真机回合数据这三样东西。
视频是燃料,不是发动机。
没有燃料,发动机转不起来;但只有燃料,你得到的是一团火,不是一辆车。
数据与来源
- V-JEPA 2:Meta,2025-06;1.2B 参数、100 万+ 小时视频、62 小时机器人视频、零样本抓取 65–80%、规划约 16 秒/动作
- Genie 3:Google DeepMind,2025-08;720p、24fps、约 22ms/帧、空间记忆约 1 分钟
- Cosmos:NVIDIA;约 2000 万小时视频训练
- EgoScale:NVIDIA,2026-02;2,000 → 20,854 小时第一人称视频,任务完成率翻倍(公司口径)
- DYNA-2:2026-08;声称 100 万小时视频 + 人-机 scaling law(公司口径,待独立复现)
- π0:Physical Intelligence;一年约 1 万小时训练数据
- 遥操作成本:约 50–150 美元/小时;8 小时班产出 2–3 小时有效数据(行业访谈)
- AgiBot World:100 万+ 条轨迹、217 任务、850TB
- Isaac GR00T Blueprint:11 小时生成 78 万条轨迹(约 6500 小时人类示范)
- sim-to-real 性能损失:50–80%(公开综述)
- 物理交互数据缺口:可用约 50 万小时 vs 需求约 10 亿小时;按当前采集速度达到 LLM 智能程度约需 12 万年(行业测算,2026)
- DeepMind 乒乓球:arXiv 2408.03906(2024-08)
- 索尼 Ace:Nature 封面论文(2026-04-22)
- V-JEPA 2.1:Meta,arXiv:2603.14482(2026-03),Ego4D 7.71 mAP、EPIC-KITCHENS 40.8 Recall@5、真实抓取 +20 个百分点
- Dreamer 4:Hafner et al., arXiv:2509.24527(2025-09),2,541 小时 Minecraft 视频、约 100 小时动作标签、离线钻石 0.7%、H100 约 20 FPS
- Project Genie / Street View:2026-01 开放、60 秒会话;2026-05 接入约 2800 亿张 Street View 图像、110 个国家;DeepMind 称其「video game quality」、不尊重物理(公开报道)
- 姚卯青:具身数据与 LLM 训练数据可能差 1 万倍以上;行业需 1 亿小时,常见任务成功率才可能到 70%–80%;互联网视频「娱乐性甚至反物理规律」(2026-08 公开采访)
*注:本文涉及公司口径的数据已标注;行业测算数据存在口径差异,仅作量级参考。*